
EmbeddingGemma 2: Google ergänzt Bilder, Audio und Video
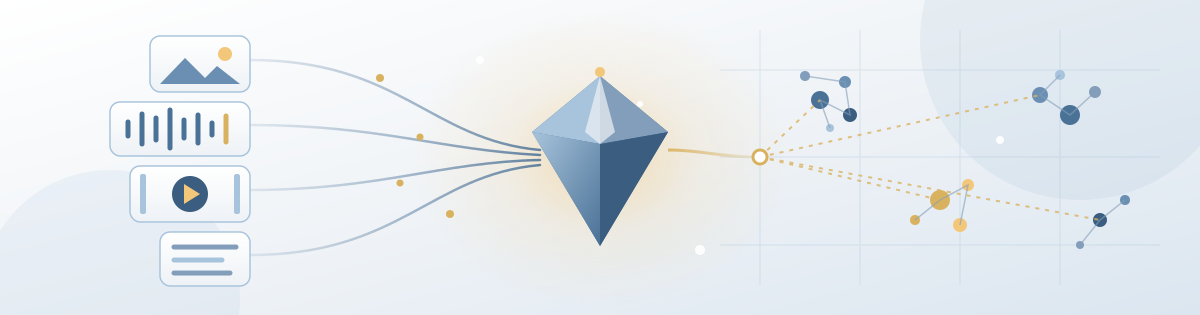
Google hat EmbeddingGemma 2 veröffentlicht, ein offenes Embedding-Modell, das neben Text jetzt auch Bilder, Audio und Video verarbeitet. Es ist trotzdem klein genug, um auf einem Smartphone zu laufen.
Ein Embedding-Modell wandelt Inhalte in eine Zahlenreihe um, die deren Bedeutung abbildet. Ähnliche Inhalte liegen dabei nah beieinander, und genau darauf beruhen semantische Suche und Retrieval. Das erste EmbeddingGemma, vorgestellt im September 2025, kam nur mit Text zurecht. Die neue Version bringt alle vier Medientypen in einem gemeinsamen Embedding-Raum unter.
In der Praxis könnte eine App eine gesprochene Sprachnotiz nehmen und die passende Stelle in einem Video finden, ohne dass dafür irgendwelche Daten das Handy verlassen müssten.
Vom reinen Text zur Multimodalität
Die Google-DeepMind-Forschungsingenieure Sahil Dua und Henrique Schechter Vera schrieben in der Ankündigung, die Resonanz auf das ursprüngliche Modell habe "unsere Erwartungen weit übertroffen". Die Zahl der Downloads beziffern sie auf mehr als 20 Millionen.
Das neue Modell basiert auf der Gemma-4-Architektur, die Google im April veröffentlicht hat. Mit 740 Millionen Parametern ist es mehr als doppelt so groß wie sein Vorgänger. Der Großteil dieses Zuwachses steckt in den Bild- und Audio-Encodern, auf die Apps, die nur Text verarbeiten, verzichten können. Als Google eine quantisierte Version des reinen Textkerns mit 270 Millionen Parametern auf einem Google Pixel 11 Pro testete, belegte sie rund 191 Megabyte Arbeitsspeicher.
Die Speicherfrage
Das Modell auszuführen ist nur ein Teil der Kosten. Jedes Embedding besteht aus 768 Zahlen, und jedes indexierte Foto, jeder Clip und jedes Dokument fügt einer lokalen Vektordatenbank einen weiteren Eintrag hinzu.
Google nutzt ein Trainingsverfahren namens Matryoshka Representation Learning, damit Entwickler diese Zahlenreihen auf bis zu 128 Werte kürzen können. Das senkt den Speicherbedarf um bis zum Sechsfachen. Laut Googles Entwicklerleitfaden behalten Bild-, Video- und Sprachsuche bei 256 Werten etwa 95 % der Qualität der vollen Länge.
Benchmarks: Code liegt vorn
Den größten Sprung gab es beim Code. EmbeddingGemma 2 erreichte im Code-Teil des Massive Text Embedding Benchmark 78,68 Punkte, fast 10 Punkte mehr als die erste Version. Google zielt damit auf Entwickler, die Retrieval für Coding-Agenten bauen - eine Gruppe, zu der bereits Leute gehören, die mit lokalen Coding-Agenten auf Consumer-Grafikkarten experimentieren. Die Werte für mehrsprachigen Text haben sich dagegen kaum verändert.
Google beansprucht außerdem Spitzenergebnisse unter den multimodalen Embedding-Modellen mit weniger als 1 Milliarde Parametern. Nach Angaben des Unternehmens schlägt das Modell bei Bild-, Video- und Audioaufgaben einige spezialisierte Modelle, die mehr als doppelt so groß sind.
Gebaut für das Zusammenspiel mit Gemma 4
EmbeddingGemma 2 nutzt denselben Text-Tokenizer und denselben Audio-Encoder wie Gemma 4. Ein Setup für Retrieval-Augmented Generation auf dem Gerät, in dem beide Modelle laufen, braucht deshalb weniger Arbeitsspeicher als zwei voneinander unabhängige Modelle.
Google setzt das Duo bereits gemeinsam in seiner Meeting-App AI Edge Foresight für den Mac ein. In der Demo-App AI Edge Gallery findet eine Funktion namens Video Moments Finder anhand einer getippten oder gesprochenen Anfrage eine Szene in einem Video.
Verfügbarkeit
Die Gewichte stehen ab sofort auf Hugging Face und Googles Kaggle unter einer Apache-2.0-Lizenz bereit, die auch kommerzielle Nutzung erlaubt. Sie funktionieren bereits mit Open-Source-Tools zur Bereitstellung wie vLLM, llama.cpp und Ollama. Google kündigte an, dass das Modell bald auch im Model Garden der Gemini Enterprise Agent Platform verfügbar sein wird.
Warum das wichtig ist
Für Entwickler dürfte der modulare Aufbau das praktischste Detail sein. Wer auf die Bild- und Audio-Encoder verzichtet, hält reine Text-Apps schlank, während die gemeinsamen Komponenten mit Gemma 4 den Speicherbedarf senken, wenn beide Modelle zusammen genutzt werden. Das deutet darauf hin, dass Google Retrieval auf dem Gerät als Baukasten aus Einzelteilen versteht und nicht als Veröffentlichung eines einzelnen Modells.
Die Veröffentlichung passt außerdem zu einem breiteren Trend hin zu kompakten, aufgabenspezifischen offenen Modellen, die Agenten unterstützen sollen, etwa AWS' kleines Entscheidungsmodell. Auch der Zuwachs beim Code-Benchmark weist in diese Richtung.
Es lohnt sich zu beobachten, ob die multimodalen Versprechen in unabhängigen Tests standhalten und ob Entwickler die Kompromisse beim Speicher in Kauf nehmen, die mit dem Indexieren großer Foto- und Videobibliotheken auf einem Handy einhergehen.