
EmbeddingGemma 2: Google suma imagen, audio y vídeo
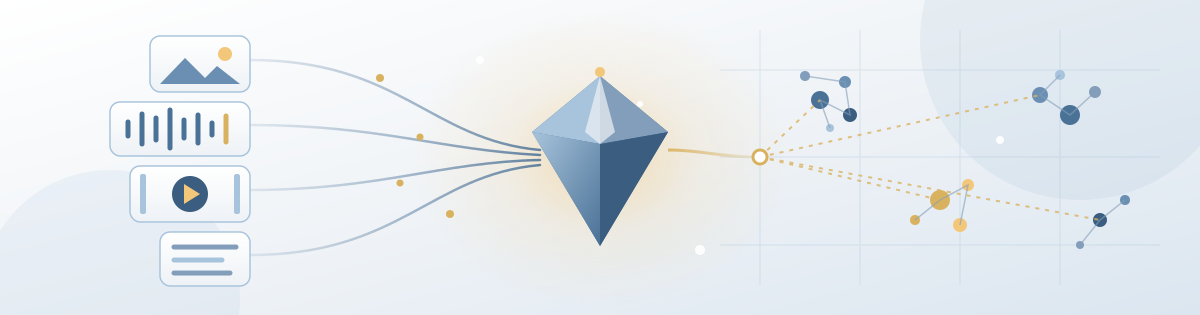
Google ha lanzado EmbeddingGemma 2, un modelo abierto de embeddings que ahora procesa imágenes, audio y vídeo además de texto. Y sigue siendo lo bastante pequeño como para funcionar en un smartphone.
Un modelo de embeddings convierte un contenido en una lista de números que recoge su significado. Los elementos parecidos quedan cerca unos de otros, y eso es lo que hace posibles la búsqueda semántica y la recuperación de información. El primer EmbeddingGemma, presentado en septiembre de 2025, solo trabajaba con texto. La nueva versión sitúa los cuatro tipos de contenido en un único espacio de embeddings compartido.
En la práctica, una aplicación podría tomar una nota de voz y encontrar el momento correspondiente en un vídeo, sin que ninguno de esos datos tuviera que salir del teléfono.
De solo texto a multimodal
Los ingenieros de investigación de Google DeepMind Sahil Dua y Henrique Schechter Vera escribieron en el anuncio que la acogida del modelo original "superó con creces nuestras expectativas". Según sus datos, las descargas superan los 20 millones.
El nuevo modelo se basa en la arquitectura Gemma 4 que Google lanzó en abril. Con 740 millones de parámetros, duplica con creces el tamaño de su predecesor. La mayor parte de ese peso adicional corresponde a los codificadores de visión y audio, que las aplicaciones que solo procesan texto pueden prescindir de cargar. Cuando Google probó una versión cuantizada del núcleo de texto de 270 millones de parámetros por sí solo en un Google Pixel 11 Pro, consumió unos 191 megabytes de memoria.
La cuestión del almacenamiento
Ejecutar el modelo es solo una parte del coste. Cada embedding es una lista de 768 números, y cada foto, clip o documento indexado añade una entrada más a una base de datos vectorial local.
Google emplea un método de entrenamiento llamado Matryoshka Representation Learning para que los desarrolladores puedan recortar esas listas hasta solo 128 números. Eso reduce el almacenamiento hasta seis veces. Según la guía para desarrolladores de Google, con 256 números la recuperación de imágenes, vídeo y voz conserva en torno al 95% de la calidad que ofrece la longitud completa.
Pruebas de rendimiento: el código, en cabeza
El código es donde más se ha avanzado. EmbeddingGemma 2 obtuvo 78,68 puntos en el apartado de código del Massive Text Embedding Benchmark, casi 10 puntos más que la primera versión. Google apunta así a los desarrolladores que crean sistemas de recuperación para agentes de programación, un grupo que ya incluye a quienes experimentan con agentes de programación locales en GPU de consumo. Las puntuaciones en texto multilingüe, en cambio, apenas se han movido.
Google también asegura obtener los mejores resultados entre los modelos multimodales de embeddings de menos de 1.000 millones de parámetros. Según la compañía, el modelo supera en tareas de imagen, vídeo y audio a algunos modelos especializados que más que duplican su tamaño.
Pensado para funcionar con Gemma 4
EmbeddingGemma 2 utiliza el mismo tokenizador de texto y el mismo codificador de audio que Gemma 4. Por eso, un sistema de generación aumentada por recuperación (RAG) en el propio dispositivo que ejecute ambos modelos necesita menos memoria que dos modelos sin relación entre sí.
Google ya usa la pareja en su aplicación de reuniones AI Edge Foresight para Mac. En la aplicación de demostración AI Edge Gallery, una función llamada Video Moments Finder localiza una escena dentro de un vídeo a partir de una consulta escrita o hablada.
Disponibilidad
Los pesos ya están disponibles en Hugging Face y en Kaggle, de Google, con licencia Apache 2.0, que permite el uso comercial. Ya funcionan con herramientas de código abierto para servir modelos como vLLM, llama.cpp y Ollama. Google ha indicado que el modelo llegará pronto al Model Garden de Gemini Enterprise Agent Platform.
Por qué es importante
Para los desarrolladores, el detalle más práctico quizá sea el diseño modular. Prescindir de los codificadores de visión y audio mantiene ligeras las aplicaciones que solo trabajan con texto, mientras que los componentes compartidos con Gemma 4 reducen la memoria cuando ambos modelos se usan juntos. Todo indica que Google concibe la recuperación en el dispositivo como un conjunto de piezas y no como el lanzamiento de un único modelo.
El lanzamiento encaja además en una tendencia más amplia de modelos abiertos compactos y especializados en tareas concretas, diseñados para dar soporte a agentes, como el pequeño modelo de decisión de AWS. La mejora en las pruebas de código apunta en esa misma dirección.
Habrá que ver si las afirmaciones sobre las capacidades multimodales se sostienen en pruebas independientes y si los desarrolladores aceptan las contrapartidas de almacenamiento que supone indexar grandes bibliotecas de fotos y vídeos en un teléfono.