
EmbeddingGemma 2: Google voegt beelden, audio en video toe
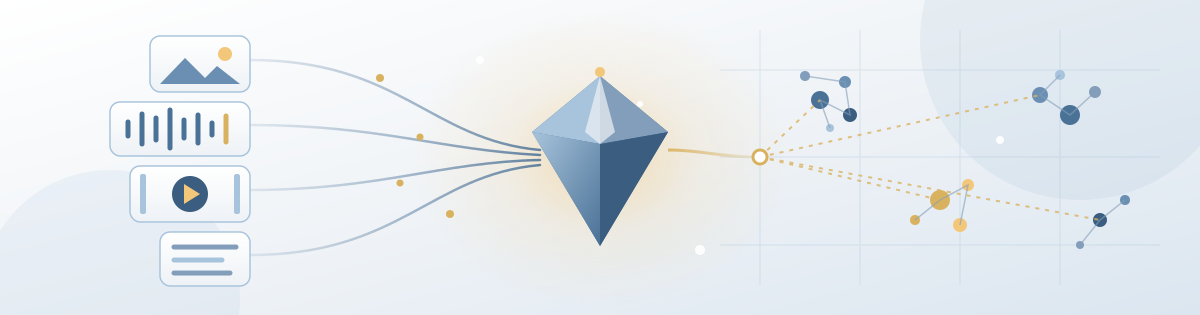
Google heeft EmbeddingGemma 2 uitgebracht, een open embeddingmodel dat naast tekst nu ook afbeeldingen, audio en video verwerkt. Het model is nog altijd klein genoeg om op een smartphone te draaien.
Een embeddingmodel zet content om in een reeks getallen die de betekenis ervan vastlegt. Vergelijkbare items komen dicht bij elkaar te liggen, en daardoor werken semantisch zoeken en retrieval. De eerste EmbeddingGemma, gepresenteerd in september 2025, kon alleen met tekst overweg. De nieuwe versie brengt alle vier de mediatypen samen in één gedeelde embeddingruimte.
In de praktijk kan een app bijvoorbeeld een ingesproken spraakmemo nemen en het bijbehorende moment in een video terugvinden, zonder dat er ook maar iets van die gegevens de telefoon hoeft te verlaten.
Van alleen tekst naar multimodaal
Sahil Dua en Henrique Schechter Vera, research engineers bij Google DeepMind, schreven in de aankondiging dat de reacties op het oorspronkelijke model "onze verwachtingen ver overtroffen". Volgens hen is het model meer dan 20 miljoen keer gedownload.
Het nieuwe model is gebouwd op de Gemma 4-architectuur die Google in april uitbracht. Met 740 miljoen parameters is het ruim twee keer zo groot als zijn voorganger. Het grootste deel van dat extra gewicht zit in de encoders voor beeld en audio, en apps die alleen tekst verwerken, kunnen die weglaten. Toen Google een gekwantiseerde versie van alleen de tekstkern van 270 miljoen parameters testte op een Google Pixel 11 Pro, gebruikte die ongeveer 191 megabyte geheugen.
De opslagkwestie
Het draaien van het model is maar een deel van de kosten. Elke embedding is een reeks van 768 getallen, en elke geïndexeerde foto, clip of elk document voegt een nieuwe regel toe aan een lokale vectordatabase.
Google gebruikt een trainingsmethode die Matryoshka Representation Learning heet, zodat ontwikkelaars die reeksen kunnen inkorten tot slechts 128 getallen. Dat scheelt tot zes keer zoveel opslag. Volgens de ontwikkelaarsgids van Google behouden zoekopdrachten op beeld, video en spraak bij 256 getallen ongeveer 95% van de kwaliteit van de volledige lengte.
Benchmarks: code aan kop
De grootste vooruitgang zit bij code. EmbeddingGemma 2 scoorde 78,68 op het codegedeelte van de Massive Text Embedding Benchmark, bijna 10 punten hoger dan de eerste versie. Google mikt hiermee op ontwikkelaars die retrieval bouwen voor codeeragents, een groep waartoe ook mensen behoren die experimenteren met lokale codeeragents op consumenten-GPU's. De scores voor meertalige tekst veranderden daarentegen nauwelijks.
Google claimt daarnaast toonaangevende resultaten onder multimodale embeddingmodellen met minder dan 1 miljard parameters. Volgens het bedrijf verslaat het model op beeld-, video- en audiotaken enkele gespecialiseerde modellen die meer dan twee keer zo groot zijn.
Gemaakt om samen te werken met Gemma 4
EmbeddingGemma 2 gebruikt dezelfde teksttokenizer en audio-encoder als Gemma 4. Daardoor heeft een retrieval-augmented generation-opstelling op het apparaat zelf, waarin beide modellen draaien, minder geheugen nodig dan twee losstaande modellen.
Google zet het duo al samen in binnen zijn vergaderapp AI Edge Foresight voor de Mac. In de demo-app AI Edge Gallery zoekt een functie genaamd Video Moments Finder een scène in een video op aan de hand van een getypte of ingesproken zoekopdracht.
Beschikbaarheid
De gewichten zijn nu beschikbaar op Hugging Face en Kaggle van Google onder een Apache 2.0-licentie, die commercieel gebruik toestaat. Ze werken al met opensource-servingtools als vLLM, llama.cpp en Ollama. Google zegt dat het model binnenkort ook in de Model Garden van Gemini Enterprise Agent Platform komt.
Waarom het ertoe doet
Voor ontwikkelaars is het modulaire ontwerp misschien wel het meest praktische detail. Door de encoders voor beeld en audio weg te laten, blijven apps die alleen met tekst werken licht, terwijl de gedeelde onderdelen met Gemma 4 geheugen besparen wanneer beide modellen samen worden gebruikt. Dat wijst erop dat Google retrieval op het apparaat ziet als een stapel bouwstenen in plaats van als de release van één enkel model.
De release past ook in een bredere trend van compacte, taakgerichte open modellen die gemaakt zijn om agents te ondersteunen, zoals het kleine beslismodel van AWS. De winst op de codebenchmark wijst eveneens die kant op.
Het is de moeite waard om in de gaten te houden of de multimodale claims overeind blijven in onafhankelijke tests, en of ontwikkelaars de opslagcompromissen accepteren die komen kijken bij het indexeren van grote foto- en videobibliotheken op een telefoon.